
Présentation
OCRFeeder est un logiciel de reconnaissance optique de caractères, un ROC ou OCR en anglais. C'est à dire qu'il est capable de lire, ou plutôt d'extraire le texte d'une image, photo ou dessin. Il peut détecter et reproduire la mise en page des documents. Il dispose aussi d'un correcteur d'orthographe.
En fait, OCRFeeder est une interface graphique, codée en Python et GTK+. Il s'emploie avec CuneiForm, GOCR, Ocrad ou Tesseract qui sont les véritables ROC.
OCRFeeder peut traiter une image, plusieurs, images, voire un dossier complet.
Il est aussi capable d'obtenir directement une image par votre scanner via SANE, et ensuite en extraire du texte. La gestion par projet est aussi disponible.
OCFeeder prend en charge tous les formats d'image courants : PNG, JPEG, WEBP, TIFF, BMP, etc.
EPS, HEIC ne semblent pas pris en charge.
Il propose plusieurs formats de fichiers de sortie, HTML, ODT, TXT, PDF or SPDF, où le le format ODT est le format par défaut.
Il y a pléthore de ROC sur le web, avec ou sans IA. Peut être souhaitez vous garder vos données chez vous ?
À l'origine OCRFeeder était un mémoire de master.
Installation
Vous l'installerez
- soit via le Centre de Contrôle de Mageia (CCM)
- soit en mode texte avec la commande Code BASH :
urpmi ocrfeeder
Les ROCs CuneiForm, GOCR, Ocrad et Tesseract sont disponibles sous Mageia.
Il est nécessaire d’installer un ROC, et les langues qu'il doit reconnaître.
Normalement, Tesseract est installé par défaut : il est présent dans les dépendances :
Code TEXT :
urpmq -d ocrfeeder
...
tesseract
tesseract-eng
...
Si ce n'est pas le cas, l'installation du paquet tesseract pourra se faire :
- soit par le CCM,
- soit par
urpmi tesseract
.
Seule la langue anglaise est installée par défaut. Pour reconnaître un texte écrit en français, c'est le paquet
tesseract-fraqu'il faudra installer.
Les paquets de langues de Tesseract sont nommés sous la forme
tesseract-xyzoù xyz représente la langue.
Code BASH :
vous en dévoilera la longue liste.urpmq tesseract
Tesseract est aussi disponible en paquet Flatpak installable via Discover.
Utilisation
Le vocabulaire, les termes utilisés dans l'interface graphique peuvent s'avérer déroutants.
Documentation
Vous trouverez des informations détaillées via le menu Aide/Aide.
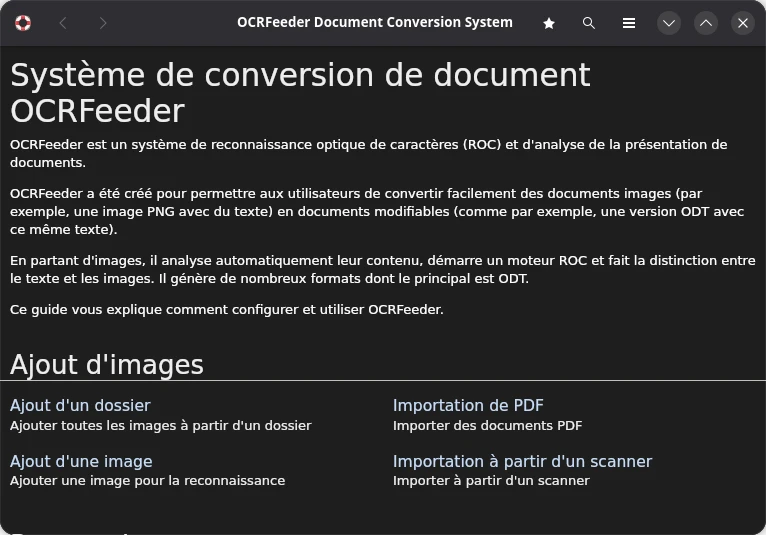
Cette documentation est presque entièrement rédigée en français, et le reste en anglais, comme le chapitre Reconnaissance.
Menu Fichier
Des captures d'écran sont visibles dans le paragraphe Un exemple ci-dessous.
Ce menu permet de charger les documents à analyser images, PDFs ou un dossier. Ils s'affichent sous forme de miniatures dans la barre latérale gauche.
Les documents chargés sont alors appelés pages.
Le bouton + permet aussi d'ajouter des images.
Pour retirer une image chargée par erreur, l'Aide affirme :
Code TEXT :
"Pour supprimer une page, cliquez sur Édition ▸ Supprimer la page ou faites un clic-droit sur la miniature de la page et choisissez Supprimer."
Clic droit ne fonctionne pas. Préférez plutôt Édition/Supprimer la page.
Menu Édition
On accède ici à la configuration avec Préférences. Choix d'un pré-traitement, moteur ROC par défaut, langue par défaut, réparer les sauts de ligne, détecter les colonnes, etc.
Menu Documents
Par ce menu on peut reconnaître un document complet, une page, des zones sélectionnées. Reconnaître c'est lire, décoder, extraire le texte de l'image chargée, de la zone sélectionnée.
On peut sélectionner une zone d'une page en traçant un rectangle à la souris.
Menu Outils
Il comporte 3 outils :
- Moteurs ROC : GOCR, Tesseract etc.
- Unpaper, le nettoyeur :
- Filtre de noir : filtre les « marges » noires dues aux scanners ou photocopieuses.
- Filtre de bruit : débruiter l'image.
- Filtre de gris : filtrer un fond grisâtre, un fond vieux papier jauni.
- Redresseur d'image : redresser l'image issue par exemple d'un scanner.
Barre latérale droite
Dans celle-ci s'affichent de haut en bas
- Une partie de la page sélectionnée.
- Les limites de la zone.
- Le moteur actif.
- Une fenêtre avec
- Texte : un échantillon du texte reconnu.
- Style : le choix de la police et de sa taille, de l'alignement pour le document final.
- Divers : la langue utilisée par le ROC.
Un exemple
Voici une vieille page sortie d'une imprimante ou d'une photocopieuse, comportant des paragraphes, et un tableau, le tout à l'encre noire.
On a choisi Document/Reconnaître la page. Les zones sélectionnée sont encadrées en bleu.
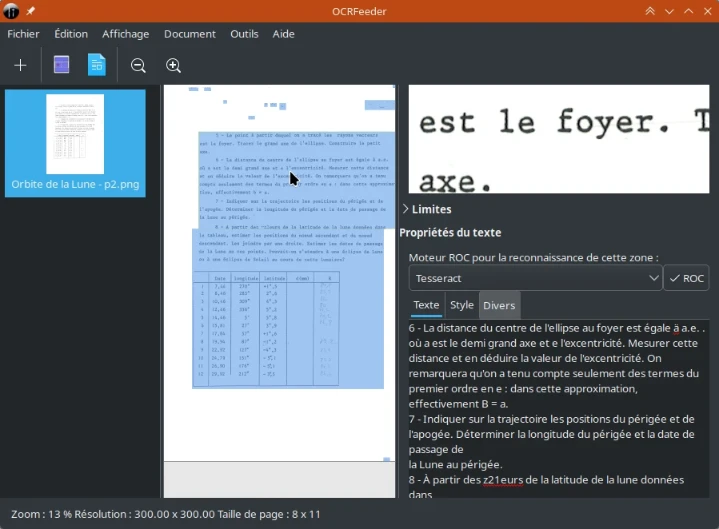
Le texte, en bas à droite, est dans l'ensemble bien reconnu, et la structure en paragraphe est bien restaurée.
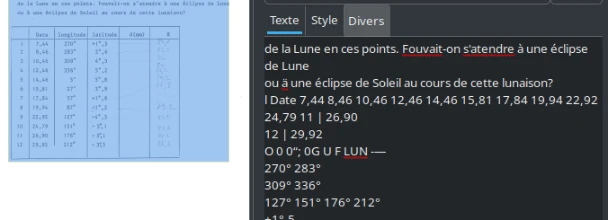
On peut voir le correcteur d'orthographe en action au paragraphe 8 - : le mot valeur n'a pas été reconnu.
Le tableau non plus :
En ligne de commandes
OCFeeder peut également être utilisé sur la ligne de commandes, c'est à dire sans interface graphique. De plus, il peut également être intégré à d'autres applications.
Avec
ocrfeeder-cliet d'après le man au minimum :
- le chemin d'accès aux fichiers à analyser, avec le paramètre
--images
, - et le nom du document à créer avec l'option
-o
.
Pourtant
Code TEXT :
$ ocrfeeder-cli --images ./imageAvecTexte.png -o ./sortieTexte
Usage: ocrfeeder-cli -i IMAGE1 [-i IMAGE2, ...] -o FILE
ocrfeeder-cli: error: no such option: --images
Il semble donc qu'à ce jour la page de man comporte une erreur.
Par contre, la commande
Code TEXT :
ocrfeeder-cli --image ./imageAvecTexte.png -o ./sortieTexte --window-size=100 -e tesseract -l fr
est fonctionnelle. Laisser l'option
--windows-sizeà sa valeur
autoprovoque des erreurs, et la valeur 100 est choisie au hasard.
Attention, la langue française est représentée cette fois par fr.
Le fichier de sortie est
sortieTexte.odt, car ODT est le format de sortie par défaut.
Le choix du format du fichier de sortie se fait avec l'option
-fet HTML, ODT, TXT, PDF or SPDF.
Plus d'information avec la commande :
Code BASH :
ocrfeeder-cli -hTesseract, en solitaire
Tesseract a été initialement développé entre 1985 et 1994 comme logiciel propriétaire dans les labos d'Hewlett-Packard à Bristol (UK) et Greeley (Colorado).
Il supporte :
- en entrée les formats d'image les plus répandus (PNG, JPEG, etc.) ;
- en sortie TXT, HTML, PDF, en autres ;
- et supporte l'unicode (UTF8) et reconnait plus de 100 langues.
Tesseract a été rendu open source en 2005.
Tesseract n'ayant pas d'interface graphique, il s'utilise en console. Il est nécessaire de lister les langues installées pour la reconnaissance avant la première utilisation : comme francophone, après l'installation ci-dessus, vous devriez avoir ceci :
Code TEXT :
tesseract --list-langs
List of available languages in "/usr/share/tessdata/" (2):
eng
fra
Un exemple d'utilisation.
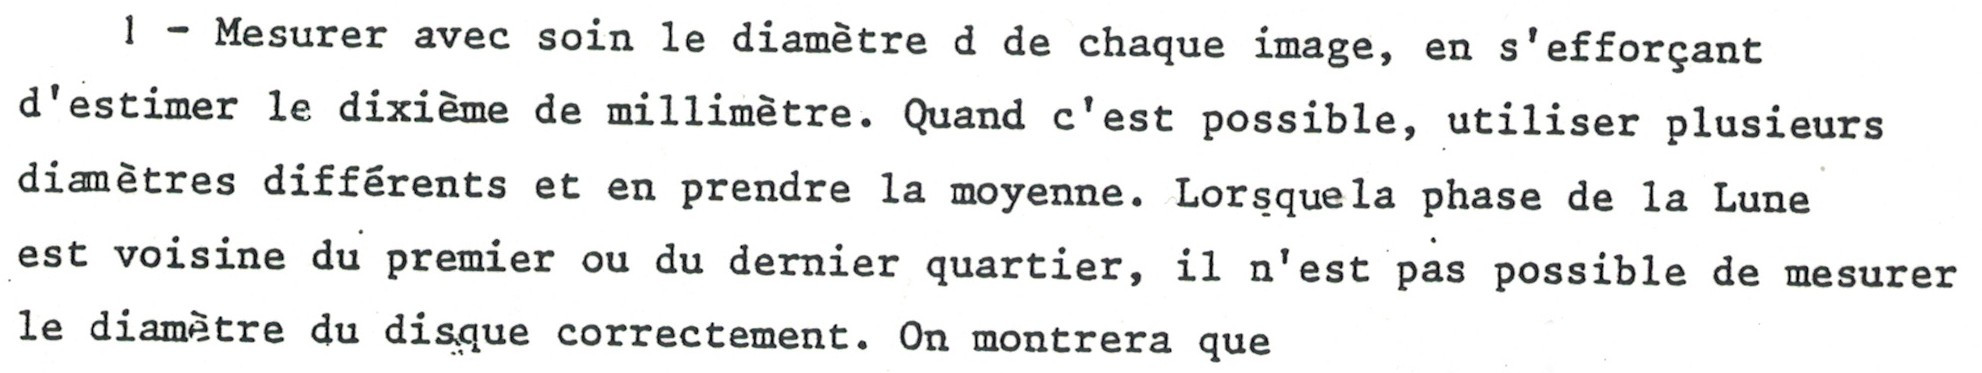
Le texte en français n'est pas tout à fait horizontal, et l'image est un peu bruitée.
Code TEXT :
$ tesseract ./mon-image1.jpg ./sortie -l fra
Le fichier obtenu sera le fichier texte
sortie.txt.
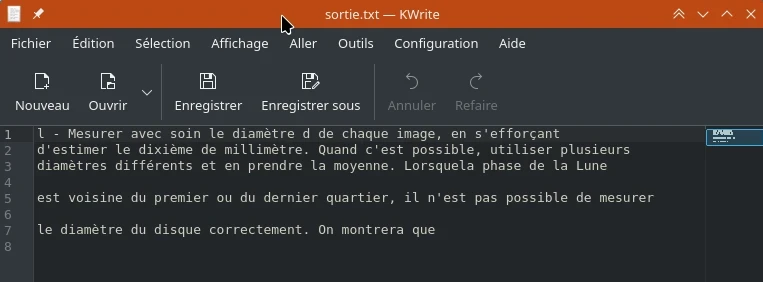
Le nombre " 1 " a été reconnu comme la lettre " l ". Et des sauts de lignes ont été insérés. Mais le " é " de " diamètre " de la dernière ligne, pourtant peu lisible, a été correctement identifié.
Pas si mal tout de même ! 👍
Il est toutes fois recommandé de nettoyer l'image avant de la confier à Tesseract, ce qui n'a pas été fait dans l'exemple.
Sitographie
- OCRFeeder sur Wikipedia, en anglais.
- OCRFeeder sur Libère ton ordi
- Ubuntuusers, très détaillé… en allemand
- Historique de Tesseract sur Wikipedia, en anglais.
- github Tesseract, en anglais.
- Historique, fonctionnalités de Tesseract sur github
- Qu’est-ce que la reconnaissance optique de caractères (OCR) ? par IBM.